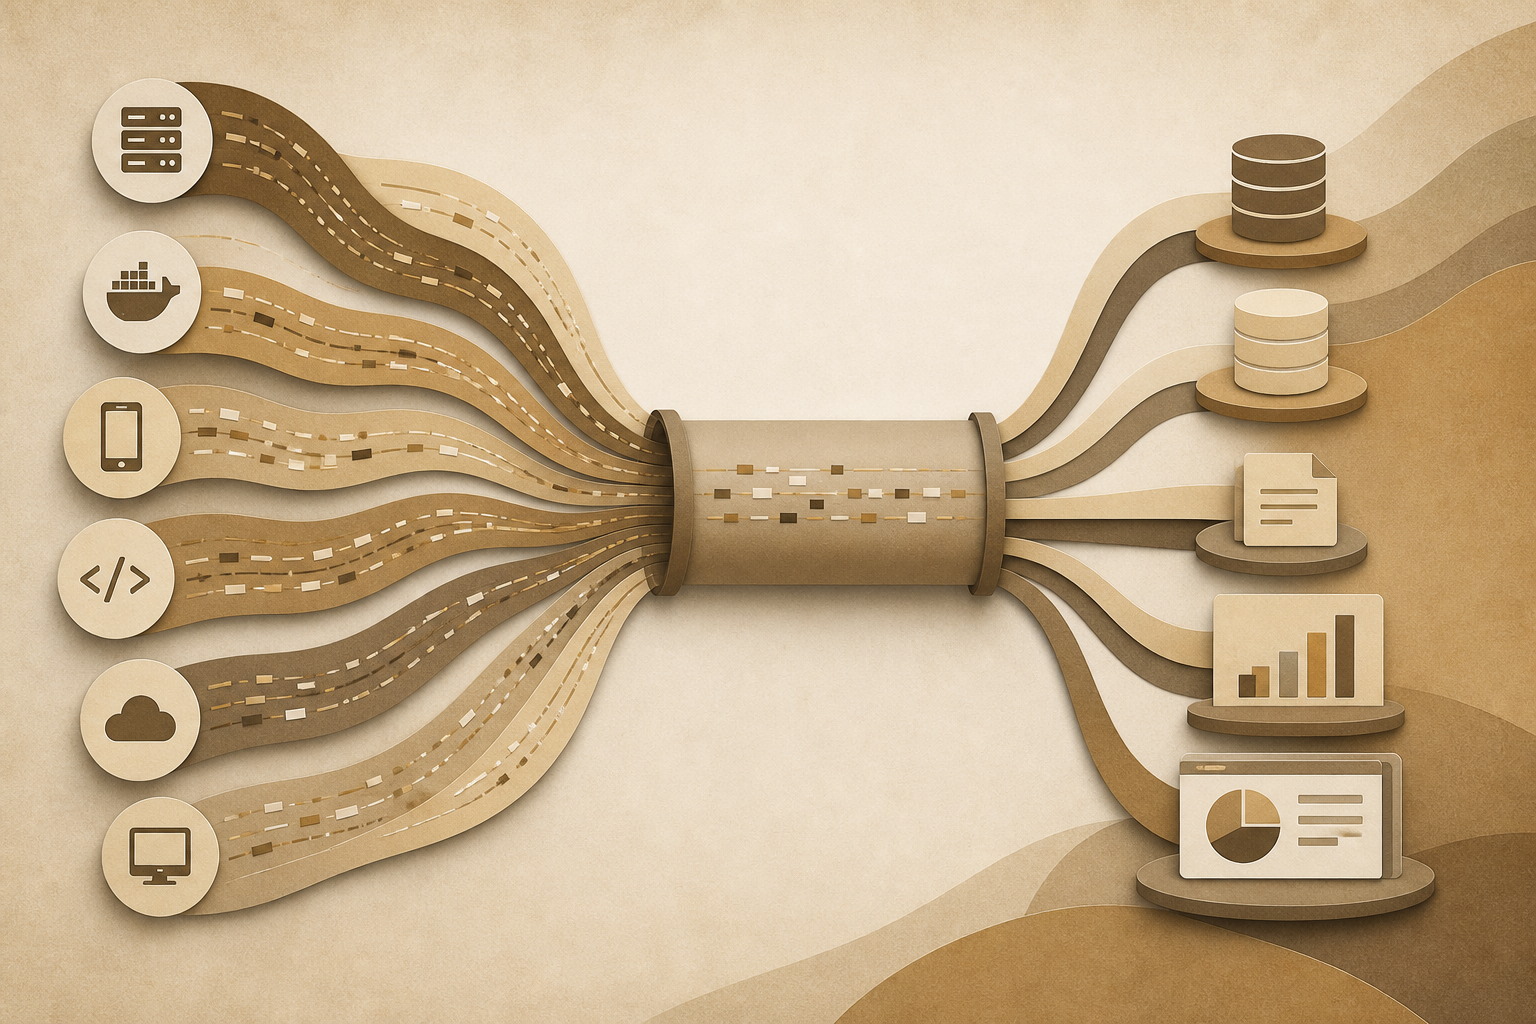
در سیستمهای توزیعشده، log همه جا هست و هیچجا یکسان نیست:
app stdout → فایل → syslog → cloud agent → …
هر تیم SDK خودش → Elasticsearch / S3 / Kafka / Splunk
نتیجه: تعویض backend = بازنویسی collectorها؛ از دست رفتن log هنگام outage مقصد؛ schema ناهمسان.
Fluentd برای همین ساخته شد:
Build Your Unified Logging Layer — Unify data collection and consumption for a better use and understanding of data.
یعنی یک لایه میانی که منابع را از backendها جدا میکند — با صدها پلاگین، و مدل «logs as streams, not files» (به قول Adam Wiggins، همبنیانگذار Heroku).
CNCF Graduated — ۱۱ آوریل ۲۰۱۹ (ورود Incubating نوامبر ۲۰۱۶). بیش از ۵۰۰۰ شرکت؛ بزرگترین کاربران در مقیاس دهها هزار سرور. همه اجزا Apache 2.0.
مشکل: coupling لاگ به مقصد
بدون لایه یکپارچه:
  App ──SDK──► ES
  App ──agent──► S3
  App ──file──► grep دستی

با Fluentd:
  Sources ──► Fluentd (tag + buffer + route) ──► ES / S3 / Kafka / …
                    ▲
تعویض output بدون تغییر app| معیار | rsyslog فقط | Filebeat alone | Vendor agent | Fluentd |
|---|---|---|---|---|
| پلاگین اکوسیستم | محدود | Beats/ELK | vendor | ۵۰۰+ |
| جداسازی source/dest | ضعیف | متوسط | قفل | قوی |
| Buffer / retry | وابسته | صف | وابسته | first-class |
| JSON-centric | نه لزوماً | JSON رایج | وابسته | طراحیشده روی JSON |
| CNCF | — | — | — | ✅ Graduated |
| همراه سبک | — | — | — | Fluent Bit |
Fluentd جایگزین SIEM یا Elasticsearch نیست — collector و router در مسیر observability است.
Fluentd چیست؟
طبق fluentd.org و docs:
- open source data collector برای unified logging layer
- log را بهصورت JSON (machine-readable) درمان میکند
- هسته با عملکرد بالا (C) + انعطاف Ruby برای پلاگین/اسکریپت
- proven در مقیاس: ۵۰٬۰۰۰+ سرور در بزرگترین استقرارهای گزارششده
- اکوسیستم پلاگین برای input، output، filter، parser، buffer، …
Site: fluentd.org
Docs: docs.fluentd.org
Fluent Bit: fluentbit.io (همخانواده، CNCF)
Repo: github.com/fluent/fluentd
خالق: Sadayuki “Sada” Furuhashi (Treasure Data)، ۲۰۱۱
نقل Matz: «programmer happiness و performance همزمان» — Ruby فراتر از وب.
بستهٔ مدرن توزیع: fluent-package (جایگزین مسیرهای قدیمی td-agent در docs جدید).
تاریخچه و CNCF
| تاریخ | رویداد |
|---|---|
| ۲۰۱۱ | ایجاد Fluentd |
| ۸ نوامبر ۲۰۱۶ | CNCF Incubating |
| ۱۱ آوریل ۲۰۱۹ | CNCF Graduated (ششمین پروژه Graduated بعد از K8s، Prometheus، Envoy، CoreDNS، containerd) |
| ongoing | Fluent Bit بهعنوان agent سبک؛ OTLP و cloud-native logging |
مدل داده: Event
هر event سه بخش دارد:
| بخش | معنی |
|---|---|
| tag | برچسب نقطهگذاریشده برای routing (app.access, kube.var.log) |
| time | زمان رویداد |
| record | payload ساختیافته (معمولاً JSON/hash) |
Routing با <match> و الگوی tag (*, **, a.b.*) انجام میشود — قلب Unified Logging Layer.
معماری Pipeline
Source(s)
    │
    ▼
┌─────────┐   ┌────────┐   ┌────────┐   ┌────────┐   ┌────────┐
│ Input   │──►│ Parser │──►│ Filter │──►│ Buffer │──►│ Output │
└─────────┘   └────────┘   └────────┘   └────────┘   └────────┘
   tail/http      nginx         enrich      file/mem      ES/S3/…
   forward        json          grep
syslog regexp geoip| نوع پلاگین | نقش | مثال |
|---|---|---|
| Input | جمعآوری | tail, forward, http, syslog, systemd |
| Parser | متن خام → ساختار | json, nginx, apache2, regexp, csv |
| Filter | غنیسازی / حذف / بازنویسی tag | record_transformer, grep, parser, rewrite_tag_filter |
| Buffer | batch، دوام، retry | file, memory |
| Output | مقصد | elasticsearch, s3, kafka, forward, stdout |
| Formatter | شکل خروجی | json، csv، … |
| Storage / Metrics / SD | state، متریک داخلی، discovery | طبق docs |
Buffer حیاتی است: اگر Elasticsearch لحظهای down باشد، chunkها روی disk میمانند و با backoff دوباره ارسال میشوند — «at-least-once» عملیاتی در مسیر لاگ.
نمونه Config
<source>
  @type tail
  path /var/log/nginx/access.log
  pos_file /var/log/fluentd/nginx.access.pos
  tag web.nginx
  <parse>
    @type nginx
  </parse>
</source>

<filter web.nginx>
  @type record_transformer
  <record>
    hostname "#{Socket.gethostname}"
    environment "production"
  </record>
</filter>

<match web.nginx>
  @type elasticsearch
  host es.example.com
  port 9200
  logstash_format true
  <buffer>
    @type file
    path /var/log/fluentd/buffer/es
    flush_interval 5s
    retry_type exponential_backoff
  </buffer>
</match>
تعویض مقصد به S3 = تغییر بلوک <match> — بدون دست زدن به app یا input.
Forward protocol
Fluentd/Fluent Bit اغلب با @type forward به هم وصل میشوند:
Node (Fluent Bit DaemonSet) ──forward──► Aggregator (Fluentd) ──► ES / S3الگوی کلاسیک Kubernetes: Bit روی edge، Fluentd در مرکز برای پردازش سنگینتر.
Fluentd در برابر Fluent Bit
هر دو زیر چتر Fluent / CNCF هستند — نقشها متفاوت:
| Fluentd | Fluent Bit | |
|---|---|---|
| وزن | سنگینتر، انعطاف پلاگین Ruby | بسیار سبک، C، footprint کم |
| نقش رایج | aggregator / پردازش پیچیده | DaemonSet / edge / IoT |
| پلاگین | ۵۰۰+ (جامعه وسیع) | دهها تا ۱۰۰+ built-in در باینری |
| Telemetry | عمدتاً logs (گسترشپذیر) | Logs + Metrics + Traces + OTLP |
| حافظه | بیشتر | بهینهشده برای container |
OpenAI و دیگران برای مقیاس agent روی node اغلب Fluent Bit را tune میکنند؛ Fluentd همچنان برای routing غنی و پلاگینهای سازمانی قوی است. خیلی pipelineها هر دو را با هم دارند.
Use cases
| سناریو | الگو |
|---|---|
| جستجوی لاگ شبیه Splunk | tail/parse → ES / OpenSearch |
| آرشیو ارزان | → S3 / GCS با buffer |
| Analytics / lake | → HDFS / object + batch |
| Streaming | → Kafka / Pulsar |
| Alerting | filter روی status≥500 → webhook / Slack |
| Kubernetes | container logs → Bit/Fluentd → backend |
| Multi-tenant routing | tag بر اساس namespace → index جدا |
Kubernetes
الگوهای رایج:
- Fluent Bit DaemonSet روی هر node — خواندن
/var/log/containers - Enrich با metadata کوبرنتیز (pod، ns، labels)
- Forward به Fluentd StatefulSet/Deployment (اختیاری) یا مستقیم به Loki/ES/Cloud
- GitOps مقادیر Helm با Argo CD
# مفهومی — chart رسمی/جامعه Fluent را از docs روز بگیرید
helm repo add fluent https://fluent.github.io/helm-charts
helm install fluent-bit fluent/fluent-bit -n logging --create-namespace
برای فقط Fluentd بهعنوان collector روی node هم DaemonSet ممکن است؛ در تراکم بالا Bit معمولاً انتخاب اول edge است.
لاگهای امنیت از Falco را هم میتوان به همان pipeline فرستاد (از طریق Falcosidekick → HTTP/Kafka → Fluentd).
قابلیت اطمینان و Buffer
<buffer>
  @type file
  path /var/log/fluentd/buffer/out
  chunk_limit_size 8MB
  queue_limit_length 64
  flush_mode interval
  flush_interval 5s
  retry_type exponential_backoff
  overflow_action block   # یا drop_oldest_chunk — آگاهانه انتخاب کنید
</buffer>
نکات:
- file buffer برای production وقتی از دست نرفتن لاگ مهم است
- disk جدا برای buffer تا root پر نشود
overflow_actionرا با SLO هماهنگ کنید (block vs drop)- نظارت روی طول صف و retry
Observability خود Fluentd
- متریکهای داخلی پلاگینها
- monitor plugin / Prometheus exporters در اکوسیستم
- log خود Fluentd را جدا نگه دارید تا loop نشود
اگر مقصد ES کند است، اول buffer و upstream را ببینید — نه اینکه فقط replica Fluentd زیاد کنید.
امنیت
- Fluentd اغلب به فایلهای لاگ و شبکه داخلی دسترسی دارد — RBAC و hostPath را محدود کنید
- TLS برای
forwardو خروجی به ES/Kafka - secretها در env/Secret کوبرنتیز — نه plaintext در ConfigMap عمومی
- ورودی
httpرا بدون auth به اینترنت باز نکنید - تصاویر رسمی و بهروزرسانی منظم (وابستگی Ruby gems)
Ingress لاگ از Contour / Envoy access log هم میتواند به Fluentd برسد.
مقایسه با جایگزینها
| نیاز | انتخاب |
|---|---|
| Unified layer + پلاگین زیاد | Fluentd |
| Agent فوقسبک / OTLP edge | Fluent Bit |
| ELK-native shipper | Filebeat / Elastic Agent |
| Grafana stack | Alloy / Promtail → Loki |
| Vendor SaaS فقط | Datadog agent، … |
| فقط syslog سازمانی | rsyslog / syslog-ng |
ارتباط با stack شما
Pods / Nodes / [Falco](/blog/falco-runtime-security-ebpf-guide/) alerts
        │
        ▼
Fluent Bit (DaemonSet) ──forward──► Fluentd (aggregator)
                                        │
                    ┌───────────────────┼───────────────────┐
                    ▼                   ▼                   ▼
                 OpenSearch            S3                 Kafka
                 / Loki

Cluster: [CoreDNS](/blog/coredns-kubernetes-dns-guide/) · [Cilium](/blog/cilium-ebpf-kubernetes-networking/)
Images: [Harbor](/blog/harbor-cloud-native-registry-guide/) ± [Dragonfly](/blog/dragonfly-p2p-image-distribution-guide/)
GitOps: [Argo](/blog/argo-project-kubernetes-gitops-cicd/)
Fluentd لایه telemetry transport & transform است — نه storage پایدار (Longhorn، CubeFS).
Best practices
- از روز اول tag naming convention تعریف کنید (
env.team.service.type) - Parse را نزدیک source انجام دهید — record ساختیافته زودتر
- Production: file buffer + disk جدا
- Aggregator Fluentd را از DaemonSet edge جدا کنید (Bit روی node)
- Rate و حجم لاگ را با filter/
grepکنترل کنید تا هزینه ES منفجر نشود - Multi-output با کپی مسئولانه (یا
copyplugin) — مراقب amplification باشید - Config را GitOps کنید؛ reload آگاهانه
- SLO برای lag و dropped chunks بگذارید
- PII را در filter redact کنید قبل از خروج از VPC
- نسخه fluent-package / chart را با پلاگینهای لازم pin کنید
Troubleshooting
| علامت | بررسی |
|---|---|
| داده نمیرسد | <match> اشتباه؛ tag؛ output error در log |
| حافظه بالا | memory buffer؛ chunk size؛ memory leak پلاگین |
| تأخیر زیاد | flush_interval؛ مقصد کند؛ صف buffer |
| از دست رفتن لاگ | overflow drop؛ disk پر؛ بدون file buffer |
| CPU بالا | regexp سنگین؛ ruby در record_transformer |
fluentd --dry-run -c /etc/fluent/fluent.conf
# یا در K8s
kubectl -n logging logs -l app=fluentd --tail=100
چه زمانی Fluentd؟
✅ استفاده کنید
- نیاز به جداسازی دهها منبع از چند backend
- پلاگینهای بالغ برای ES، S3، Kafka، MongoDB، …
- Aggregator مرکزی با buffer و routing پیچیده
- ترکیب با Fluent Bit در Kubernetes
⚠️ شاید نه
- فقط چند container و Loki ساده → Fluent Bit / Alloy کافی است
- تیم بدون ظرفیت ops برای صف و پلاگین Ruby
- محدودیت شدید حافظه روی هر node بدون aggregator جدا
جمعبندی
| مفهوم | توضیح |
|---|---|
| Fluentd | open source data collector — Unified Logging Layer |
| Event | tag + time + record (JSON) |
| Pipeline | Input → Parser → Filter → Buffer → Output |
| Plugins | ۵۰۰+ اتصال به اکوسیستم |
| Fluent Bit | همراه سبک برای edge و K8s DaemonSet |
| CNCF | Graduated آوریل ۲۰۱۹ |
Fluentd همان لایهای است که «لاگ را stream میکند نه فقط فایل» — و به شما اجازه میدهد backend را عوض کنید بدون اینکه application و صدها agent را از نو بنویسید.
قدم بعدی
- Quickstart — نصب fluent-package و یک
tail→stdout - Parse nginx/json و یک
<filter>enrichment - Output به Elasticsearch یا S3 با
<buffer>فایل - روی Kubernetes: Fluent Bit DaemonSet → forward به Fluentd
- Convention تگ و داشبورد lag/buffer را مستند کنید
منابع یادگیری: Fluent Bit Academy روی سایت پروژه، و docs رسمی Fluentd / Fluent Bit.
منابع
- Fluentd — fluentd.org
- Documentation
- Quickstart
- Fluent Bit
- CNCF Fluentd
- Graduation announcement
- GitHub — fluent/fluentd
منتشر شده در P30Light — بخش زیرساخت و سرور.